Knit
Agent 一天产出 20 篇文档,你找不到刚才那篇。 Knit 把它们放到对话旁边 —— 你正在聊什么,相关的那篇就在最上面。
你的 agent 也一样。 同一份排序也给它当工具用 —— 它问「哪几篇相关」,拿回排名加每篇里命中的那段原文。
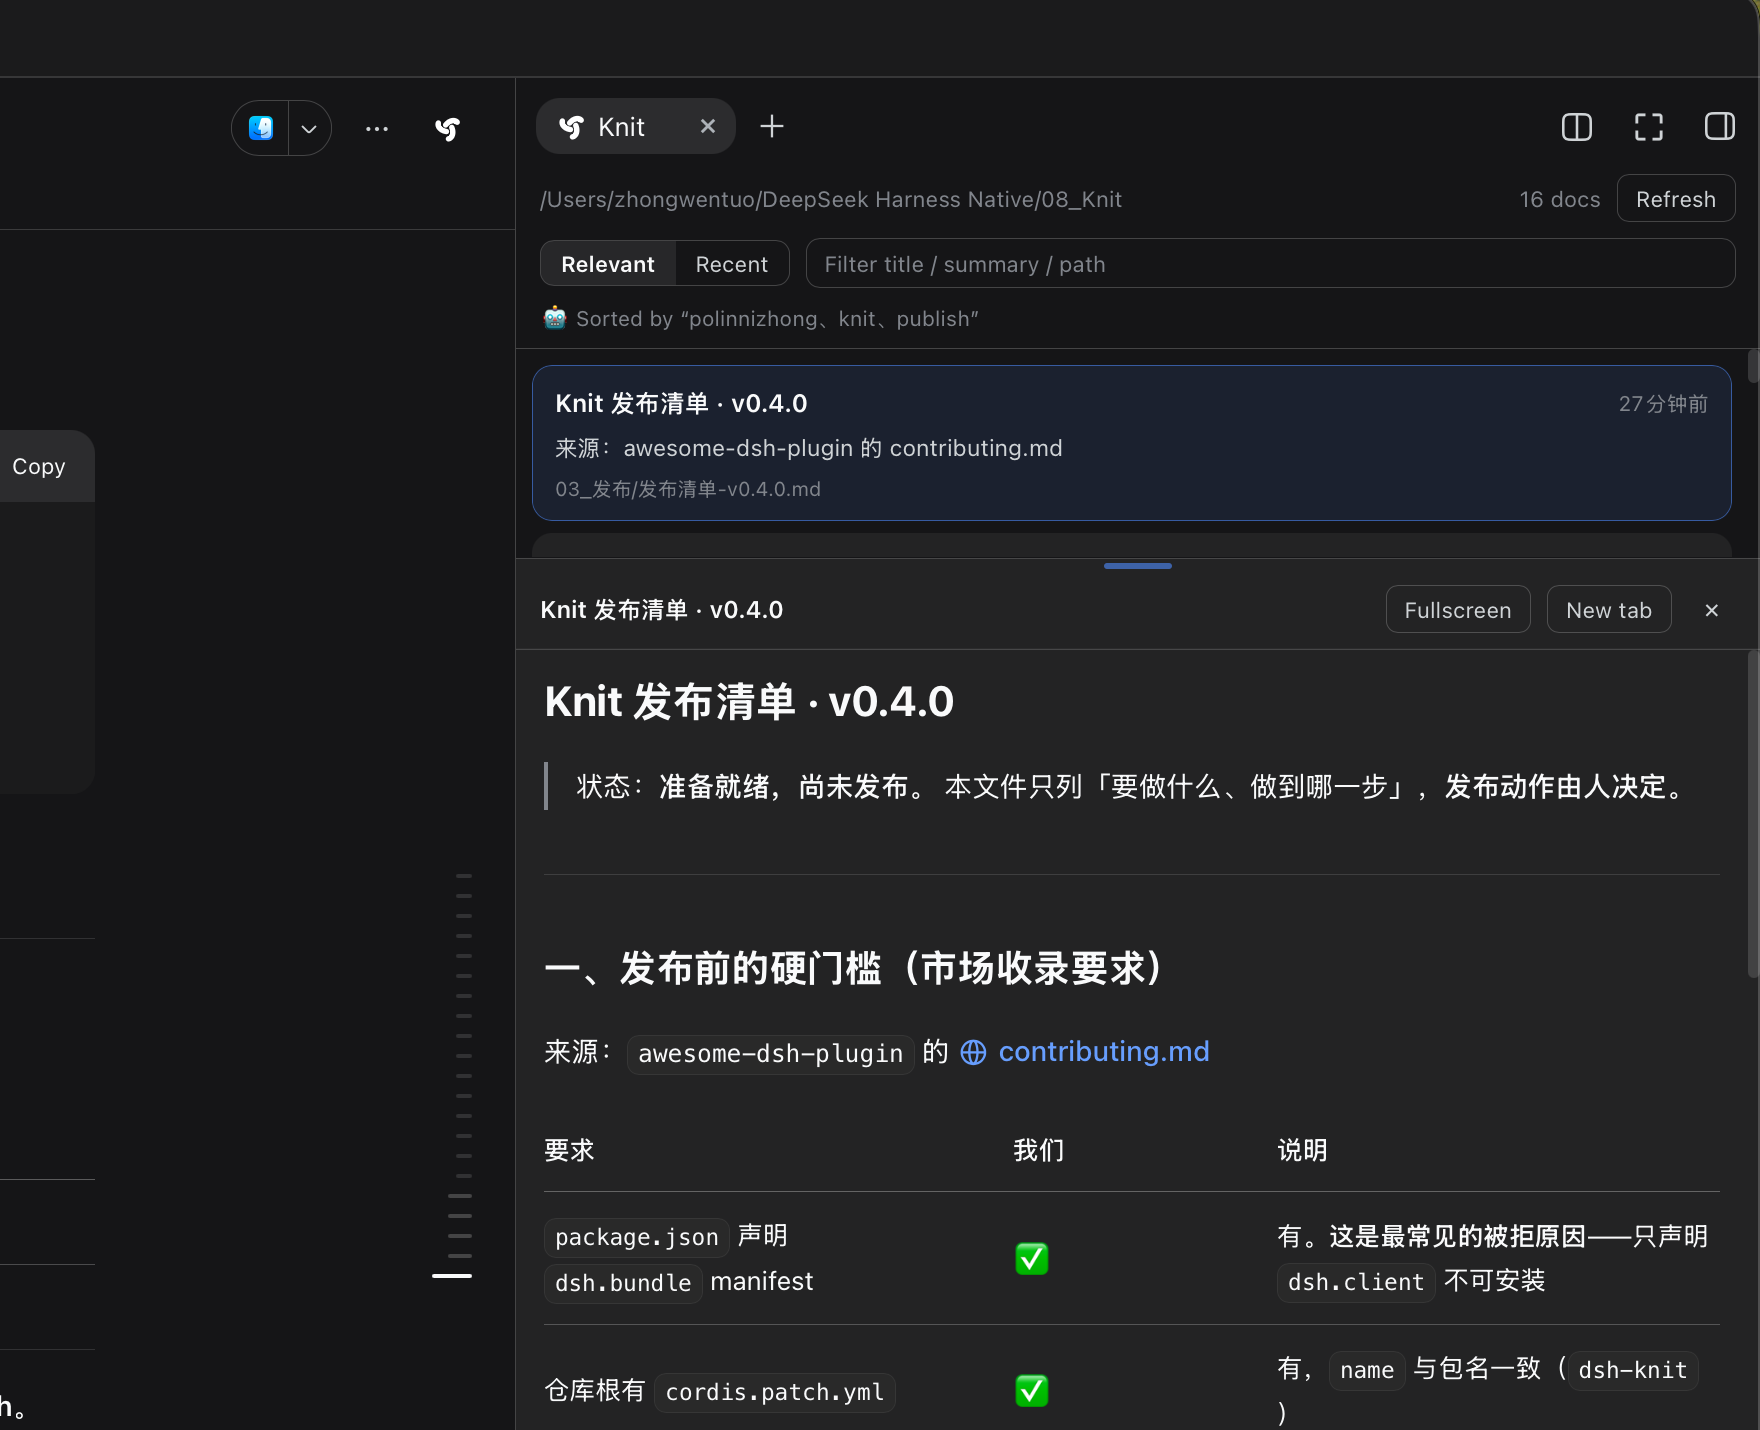
真机截图(不是原型):一个含 53 篇文档的工作区 —— 列表 + 就地预览 + 引用条。
引用条是 v0.12 加的:展开就能看到「这篇被谁引用」,点一项直接跳过去。
头部只放路径、篇数与两个开关;列表按「相关」还是「最新」排,由左边那一对页签决定 —— 按「相关」时排的就是你正在聊什么。
v0.14 起文档列表永远单列:最左边独立一列是序号(与标题第一行垂直居中),右边第一行=
Primary 点 + 标题 + 相对时间(时间靠右),摘要再往下;路径只出现在预览头里(目录收敛成一个 …/ 占位,完整相对路径在悬停提示里),列表行不再重复。
序号是跨三档连续的一条(先看 / 辅助 / 背景);「其他相关文档」不在包里、不编号,那一格用一个 · 占位 ——
空着会被读成「漏了一个号」(2026-10-01)。
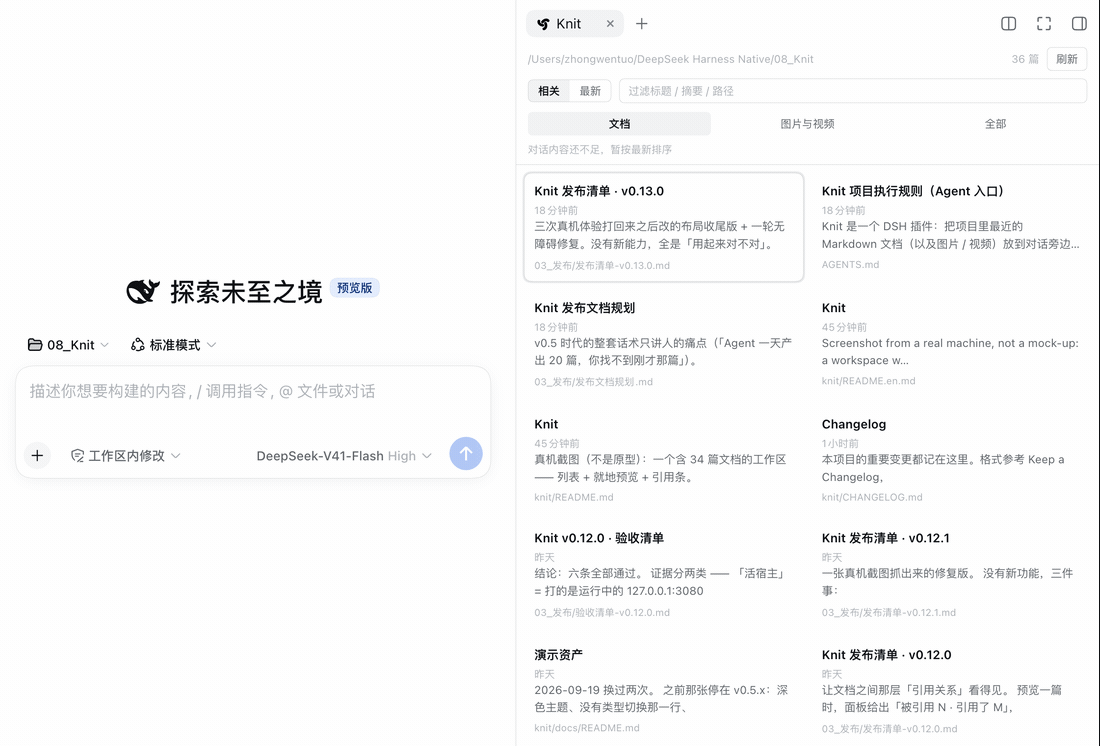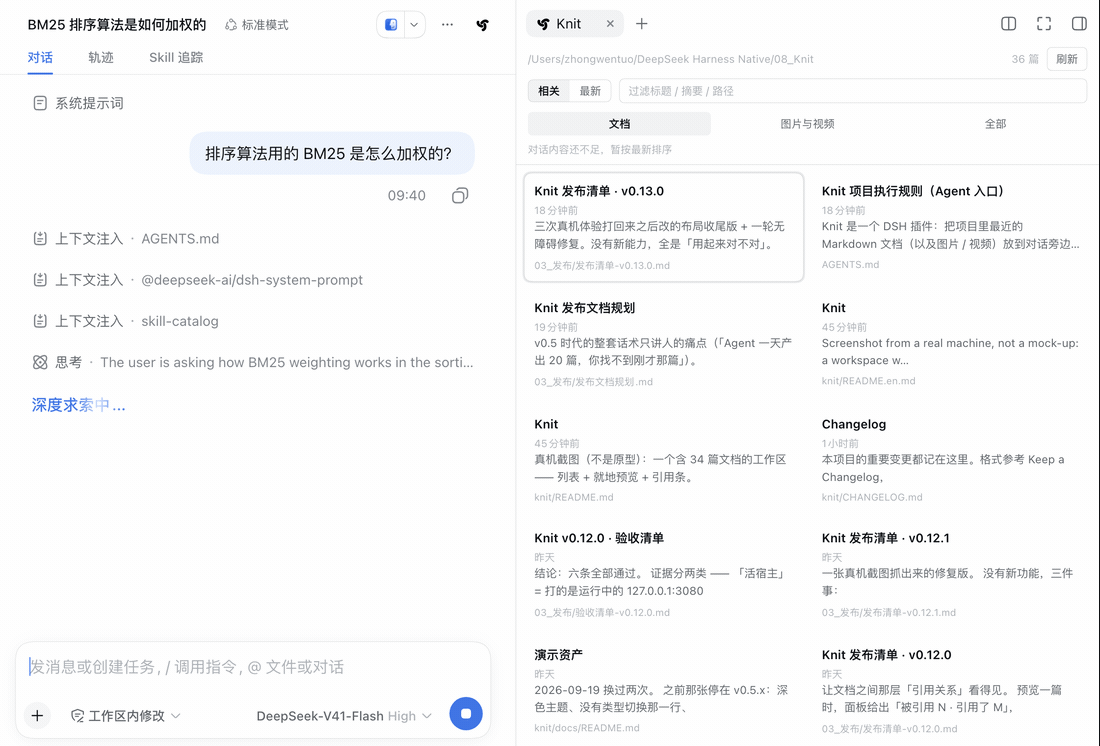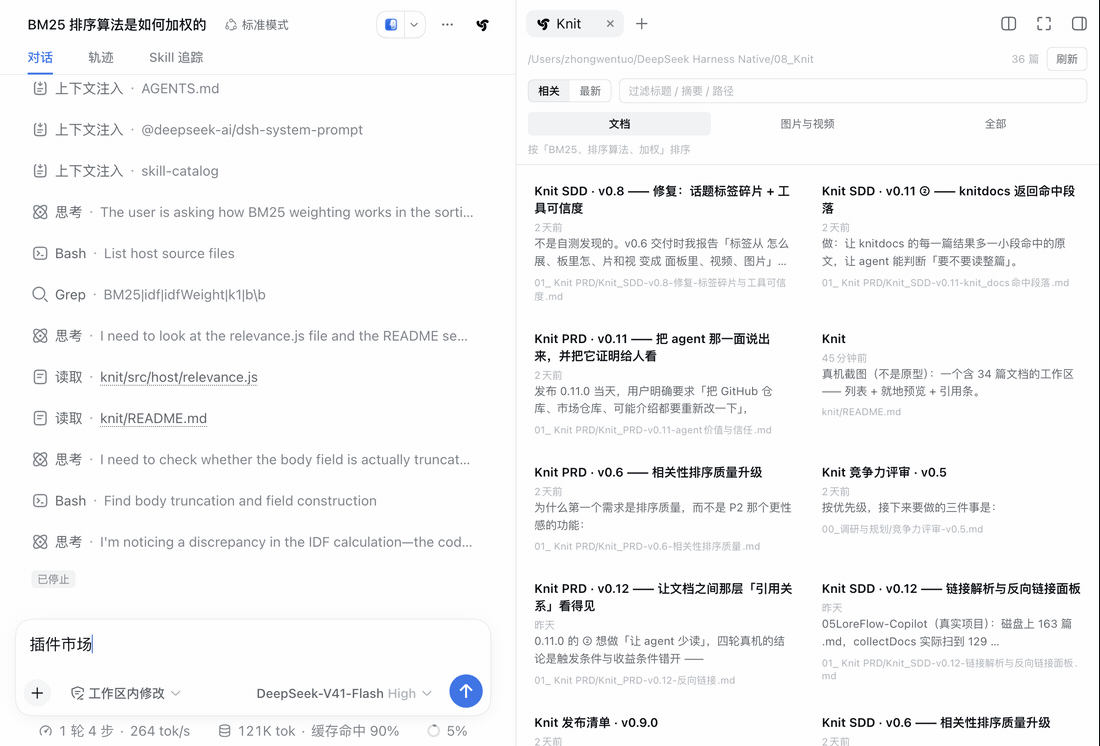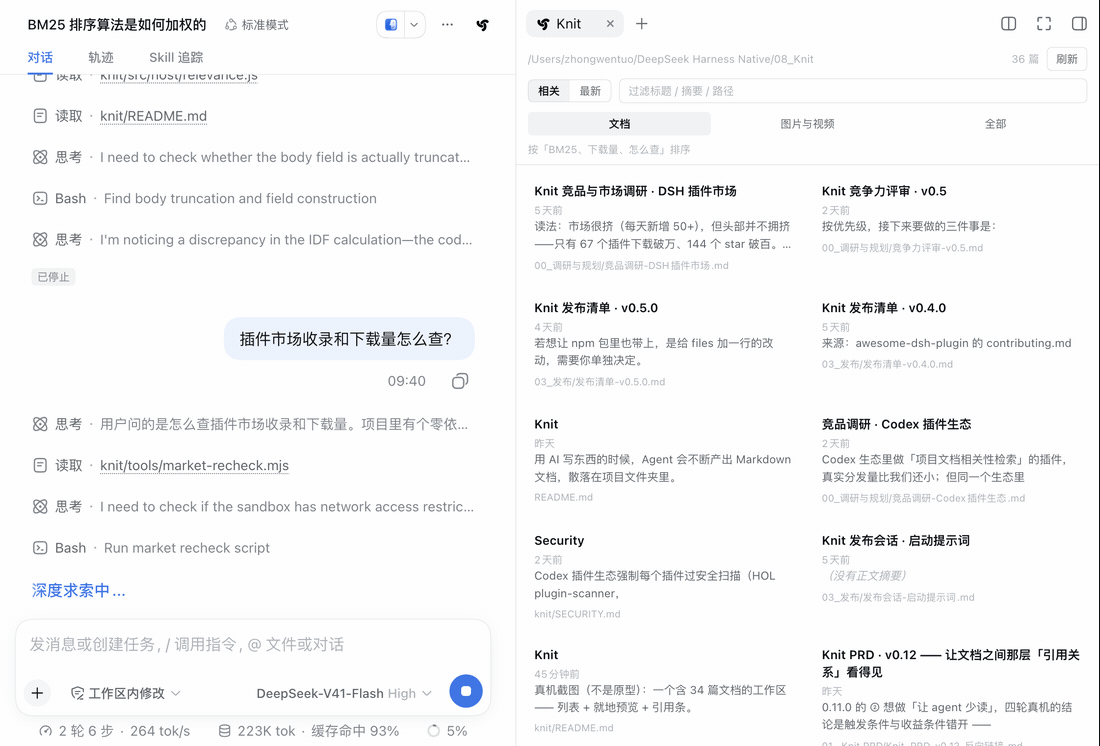
排序跟着对话走(同一个工作区、刚新开一个会话):还没聊什么时,列表按修改时间排; 问一句「排序算法用的 BM25 是怎么加权的?」,下一次轮询就把顶上几条整个换掉 —— 分组标题与跨三档连续的序号随之一起出现,每篇下面多一行「为什么」(命中在哪、怎么命中的)。 这一屏里没有文档落进主要层,所以分组从「辅助上下文」开始。 ⚠️ 面板是每 5 秒轮询一次的,所以重排落在发消息之后的 0–5 秒内、不是瞬时;动图比真实时间快。
扫整个项目文件夹的 Markdown / 图片 / 视频 · 排序跟着对话走 · 不调模型、不联网
dsh plugin --profile web add dsh-knit
这不就是个「最近文件列表」吗?
是的,但有两个关键区别:
- 范围:最近打开列表只记你点开过的文件;Knit 扫整个项目文件夹。 重启 DSH、新开会话、跨天回来,它都还在。
- 排序:它按时间排;Knit 按你正在聊什么排。
三句话说完它是什么:
- 扫整个项目文件夹的 Markdown,不只是这一轮生成的那几篇 —— 重启、换会话、跨天都还在
- 排序跟着你正在聊什么走:聊架构,架构文档浮上来;聊竞品,竞品分析浮上来
- 不调模型、不联网:全是本地字符串运算,零延迟、零成本、文档不出本机
「相关」是怎么算出来的
没有玄学,就是字符串运算。三步:
1. 读当前会话。 取最近 6 条用户 / 助手消息,只认真人输入的用户消息
(agent.inject() 塞进来的合成上下文不算,那会把话题带偏)。越新的消息权重越高:3 / 2 / 1 / 1 …
2. 抽关键词。
- 英文词:取值很高,出现 1 次就要(
chokidar、mtime这种精确词) - 中文 2/3-gram:出现 2 次,或出现在最新那条消息里
- 丢掉跨词边界的碎片:中文没有词边界,n-gram 会把相邻两个词的字粘起来 (「图片和」「个插」「的排」)。这类碎片有个共同特征 —— 首字或尾字是纯虚词, 一律丢掉。不丢的话它们会占满候选位,把「图片」「排序」这些真词全挤出去
- 虚词表过滤 + 贪心去重叠(选了「相关性排序」就不再算「相关性」和「排序」)
3. 给文档打分 —— BM25。
每个词先算 IDF:在语料里越罕见越值钱   ln(1 + (N - df + 0.5) / (df + 0.5))
再按字段加权求和:标题 ×4  +  摘要 ×2  +  正文前 2500 字 ×1
每个字段都按 BM25 饱和 + 长度归一化(k1 = 1.2,b = 0.3 / 0.5 / 0.75)
再叠 10% 的时间新鲜度微调(主排序仍是相关性)
为什么是 BM25 而不是「命中次数 × 权重」(那是最初的做法,已换掉):
- 没有 IDF 时,语料里到处都是的词(比如项目名)和罕见词一样值钱, 于是高频词不产生任何区分度,还稀释掉罕见词的分辨力
- 没有长度归一化时,长文档靠堆词就能赢
- 命中次数封顶 6 次是个手写硬拐点;
k1/b才是为这件事设计的
实测(test/eval/fixture.mjs,21 个用例,两版引擎跑同一套语料):
| top-1 命中 | MRR | |
|---|---|---|
| 旧做法(加权命中) | 76.2% | 0.830 |
| BM25 | 95.2% | 0.976 |
这套评测在 npm test 里跑,基线由 test/eval/legacy.mjs 冻结的旧引擎现算,
所以「新引擎必须显著更好」是自动验证的,而不是引用一个写死的数字。
跟「自己数关键词」比(knit/tools/scale-benchmark.mjs,N = 20/60/180/540):
语料刻意做成有真实陷阱的 —— 12 篇短而聚焦的主题文档,加上一堆「每条主题各提 5 次、
但哪一件都没讲」的长干扰文档(真实项目里的 CHANGELOG 就长这样)。
主题文档一半用描述性文件名,一半看不出内容。
| 路线 | 文件名说得清 | 文件名看不出 | MRR 随规模 |
|---|---|---|---|
| Knit(BM25) | 100% | 100% | 1.000(不随规模变) |
自己 grep -c 数关键词 |
17% | 0% | 0.313 → 0.089 |
| 只看文件名 | 100% | 0% | 0.602 |
三件事:排序强于自己数关键词(所以让 agent 重算是不理性的); 文件名匹配只在名字描述内容时好使,Knit 是唯一两种都 100% 的; 自己数的可靠性随规模单调下降。
关于那行「按「xxx」排序」:显示的是命中词在原文里覆盖的那一段,不是词表里的碎片。
中文没有词边界,候选里必然有跨词的碎片(「项目文档」会切出 项目文 / 目文档),
直接显示就成了乱码 —— 把它们的区间合并再切原文,正好还原出 项目文档。
标签是你自己打的字,所以大小写原样保留(打 BM25 就显示 BM25)。
全是字符串运算 —— 没有 embedding,没有模型调用。
并且老实说边界:
- 对话只有一两句时关键词太少,它会退回按修改时间排,并在面板上说明这一点 —— 不假装排了个序
- 语料只有三五篇时 IDF 几乎不起作用:
df的取值范围太窄,动态范围被压扁。 文档越多这个排序越准 —— 这正是它该有的样子 - 它只能排「和对话有共同词汇」的文档:如果一个词都没命中,所有文档同分, 名次就退化成按时间排
安装
dsh plugin --profile web add dsh-knit
装完重启 DSH,然后硬刷新浏览器(Cmd + Shift + R)。
怎么打开:
- 会话头部右侧的 Knit 图标按钮(就在右侧栏展开按钮旁边)—— 一键开面板
- 或右侧栏 tab 条上的「+」→「Knit 最近文档」
可选:装了 dsh-better-sidebar 的话,面板也会注册成它的一个 tab;
没装不受影响,两边是各自独立的可选依赖。
升级:命令和首次安装是同一条,装完同样要重启 DSH + 硬刷新。
反馈
这个项目当前的重心不是加功能,是搞清楚「按对话给文档排序」这件事到底有没有人在用。 所以最有价值的一句话不是「能不能加个 XX」,而是你现在是怎么绕过它的 —— 哪怕结论是「装了,但一周没打开过」,也请直说,那比一个功能建议有用得多。
- 💬 说说你在什么场景下会打开它 —— 两步、三十秒,不必客气
- 🐞 装不上 / 面板打不开 / 排得不对
- 📖 提之前先看一眼已知限制 —— 短对话退化、中文用 n-gram 近似,这几条是已知的取舍,不是 bug
一条 issue 会被当成真实信号处理。这个插件到现在一个真实用户的痕迹都没有 (npm 那个下载量是自动化版本枚举、不是人 ——
latest占比只有 14%,而真人只会装latest) —— 一条有人味儿的反馈能直接改变接下来做什么。
功能
| 能力 | |
|---|---|
| 按当前对话相关性排序(BM25 + IDF,纯本地,零模型) | ✅ |
| 当前任务上下文:把排序结果拆成 主要 / 辅助 / 相关 三层,每条都写明「为什么在这里」 | ✅ |
给 agent 用的 knit_docs 工具:让模型拿回三层任务上下文(不是一条平铺列表) |
✅ |
文档生命周期(v0.17):每篇推荐文档现在处于 未读 / 已读 / 读后已更新 / 修改后已重新读取 哪一档,另外给出最近读了哪篇、包外读了哪几篇、上下文最近一次怎么变 |
✅ |
| 相关性 / 修改时间双模式一键切换(偏好记在 localStorage) | ✅ |
扫描会话工作区里的 .md(递归,深度 ≤ 6,跳过 node_modules / .git / dist) |
✅ |
| 每项显示:H1 标题(无则文件名)+ 相对时间 + 首段摘要 | ✅ |
| 文档列表永远单列(v0.14 起,多列那套已整体删除);序号在每行最左边独立成一列(与标题第一行垂直居中),其余数据全在右边堆叠(右边第一行=Primary 点 + 标题 + 相对时间,时间靠右),摘要再往下;列表行里不再有路径 —— 它和预览头那行可点的路径重复,只保留后者 | ✅ |
| 单击就地展开预览,再点收起 | ✅ |
相对路径图片真正渲染(./img/a.png、../assets/b.png) |
✅ |
| 文档 / 媒体 / 全部 三类一键切换(偏好记住,默认仍是文档,老体验不变);选中态是中性灰填充,不带品牌色描边(页签「媒体」2026-10-06 由「图片与视频」改短) | ✅ |
| 图片与视频:方形缩略图网格,格子基准固定 104px、列数由宽度连续数出来(320px → 2 列 / 632px → 5 列 / 1200px → 10 列),格子大小基本不变;纵向有多少行就铺多少行,超出交给列表滚动;视频自动取首帧、叠播放三角与时长角标(零依赖、不转码) | ✅ |
| 点图片 / 视频在面板内就地预览:图片大图、视频可播放可拖动(HTTP Range 流式,不全量下载) | ✅ |
| 「全部」视图分上下两区:文档最多 4 条(超出给「查看全部 →」);图片视频不截断,只给计数 | ✅ |
预览面板可拖高度(20%–80%,位置记住)、可全屏,Esc 退出 |
✅ |
| 「本地打开」:用系统默认应用打开当前预览的这篇文档(预览头的路径同样可点,完整路径在悬停提示里) | ✅ |
| 双击在新标签页打开(官方文档预览,带 PDF 渲染器与渲染方式切换) | ✅ |
| 过滤框:按标题 / 摘要 / 路径实时过滤 | ✅ |
| 点工作区路径:用系统文件管理器打开项目文件夹 | ✅ |
| 悬停入口按钮偷看:弹只读浮层列最近 5 篇,点击才进右边栏(不推挤布局;浮层只有「头 + 列表」,没有多余的横线与提示语) | ✅ |
键盘导航:↑ ↓ 移动即预览 / Enter 切换 / Esc 收起;媒体档 ← → 按屏幕位置跨行,Home / End 到首尾(文档档永远单列,← → 没有空间含义) |
✅ |
| 每 5 秒自动刷新 + 手动刷新;2 分钟内改动过的文档打 🆕 | ✅ |
| 中英双语,跟随 DSH 语言实时切换(不用重载插件) | ✅ |
列表是标准 listbox/option 语义,选中项用 aria-activedescendant 播报;媒体网格里的键盘焦点有可见描边 |
✅ |
| 零模型调用、零网络出口 | ✅ |
相关度不做可视化(不显示百分比、不画长条)—— 排序本身就是答案,名次即相关度。
另外两档长什么样
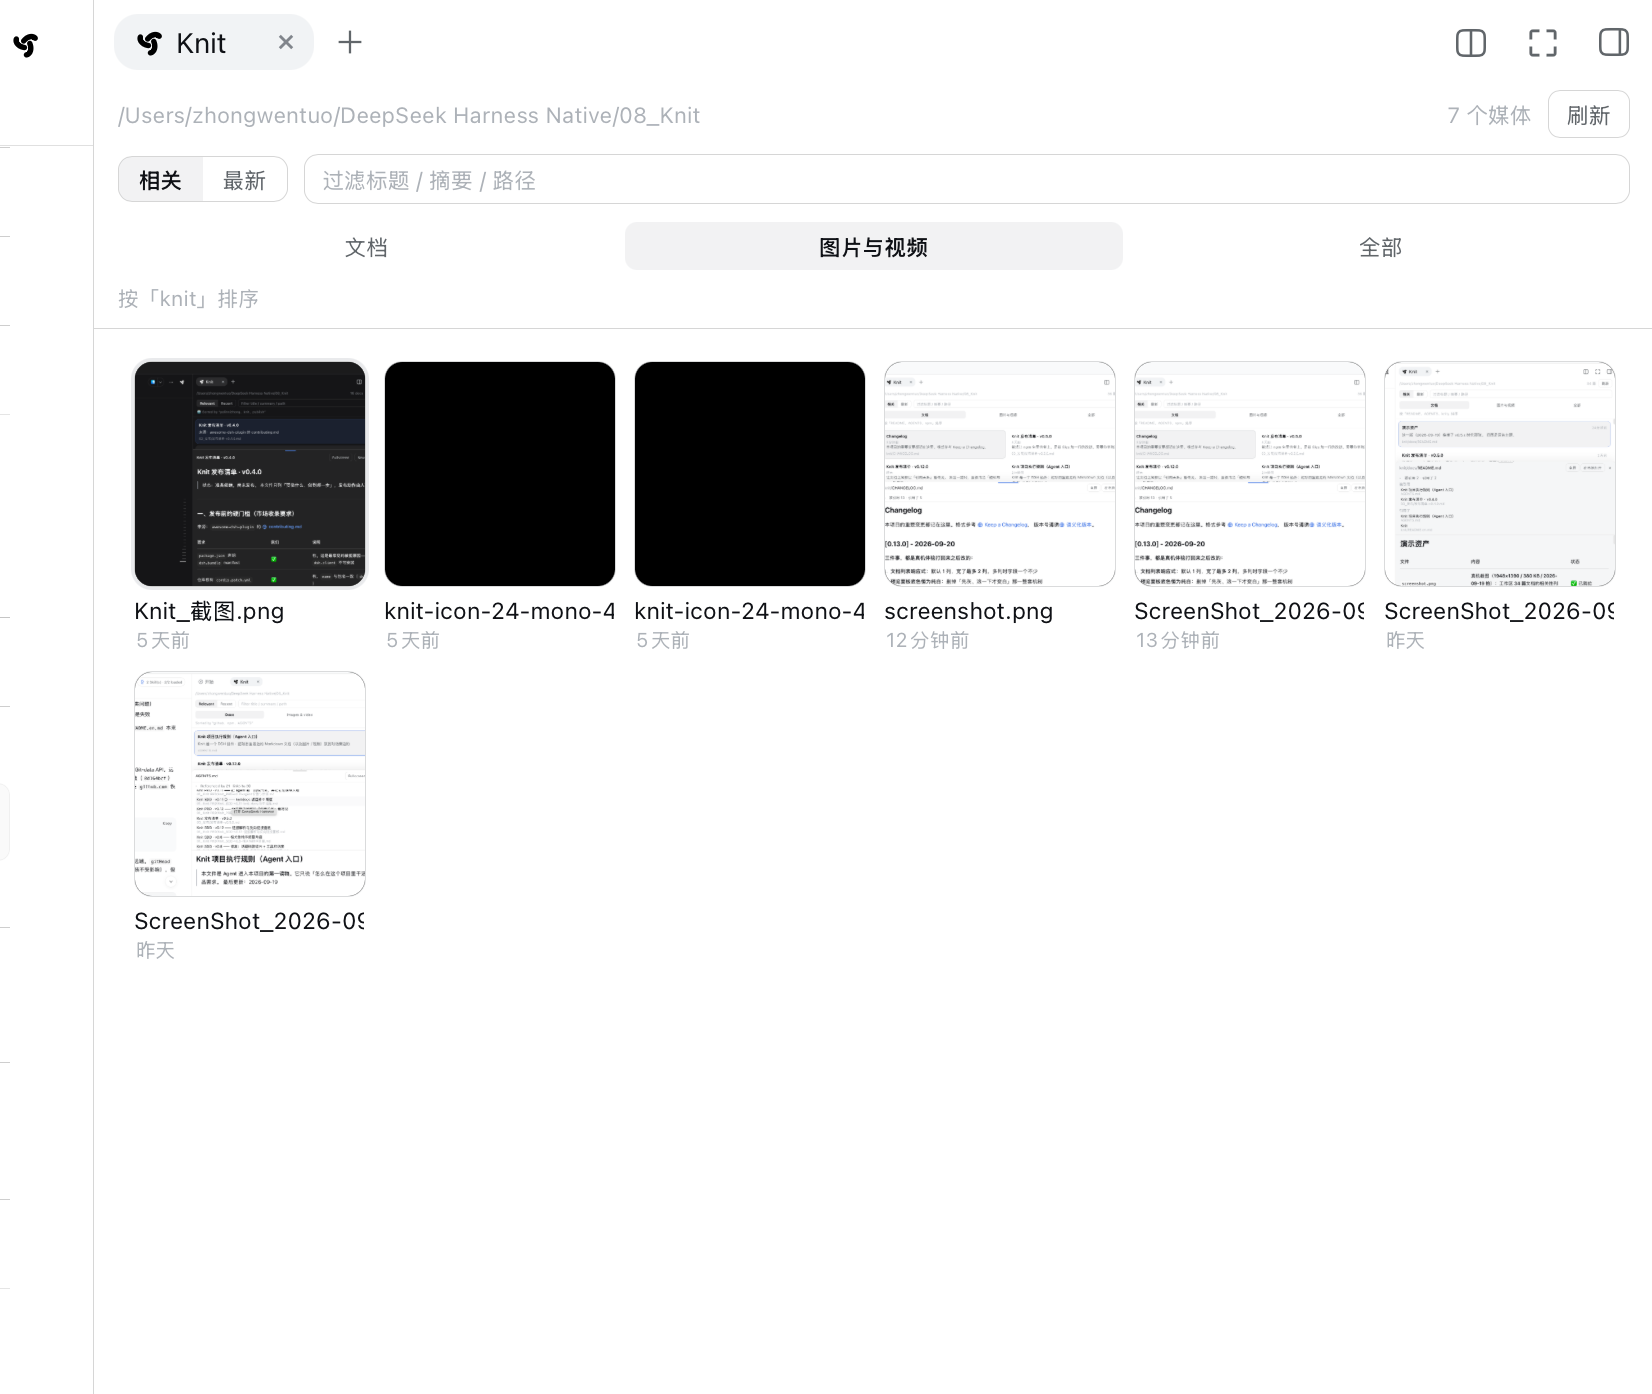
媒体:方形缩略图,列数跟着面板宽度连续变 —— 这一屏是 6 列,格子约 112px。 列出的就是工作区里真实的图片与 SVG 文件 —— 这个工作区正好有几张截图、一张演示动图和一个 单色 SVG 图标,所以看起来像一屏文件缩略图(那个纯黑方块就是图标本身,不是加载失败)。 视频会取首帧当海报、中央叠播放三角、右下角叠时长,只是这个工作区里没有视频,所以这一屏看不到。
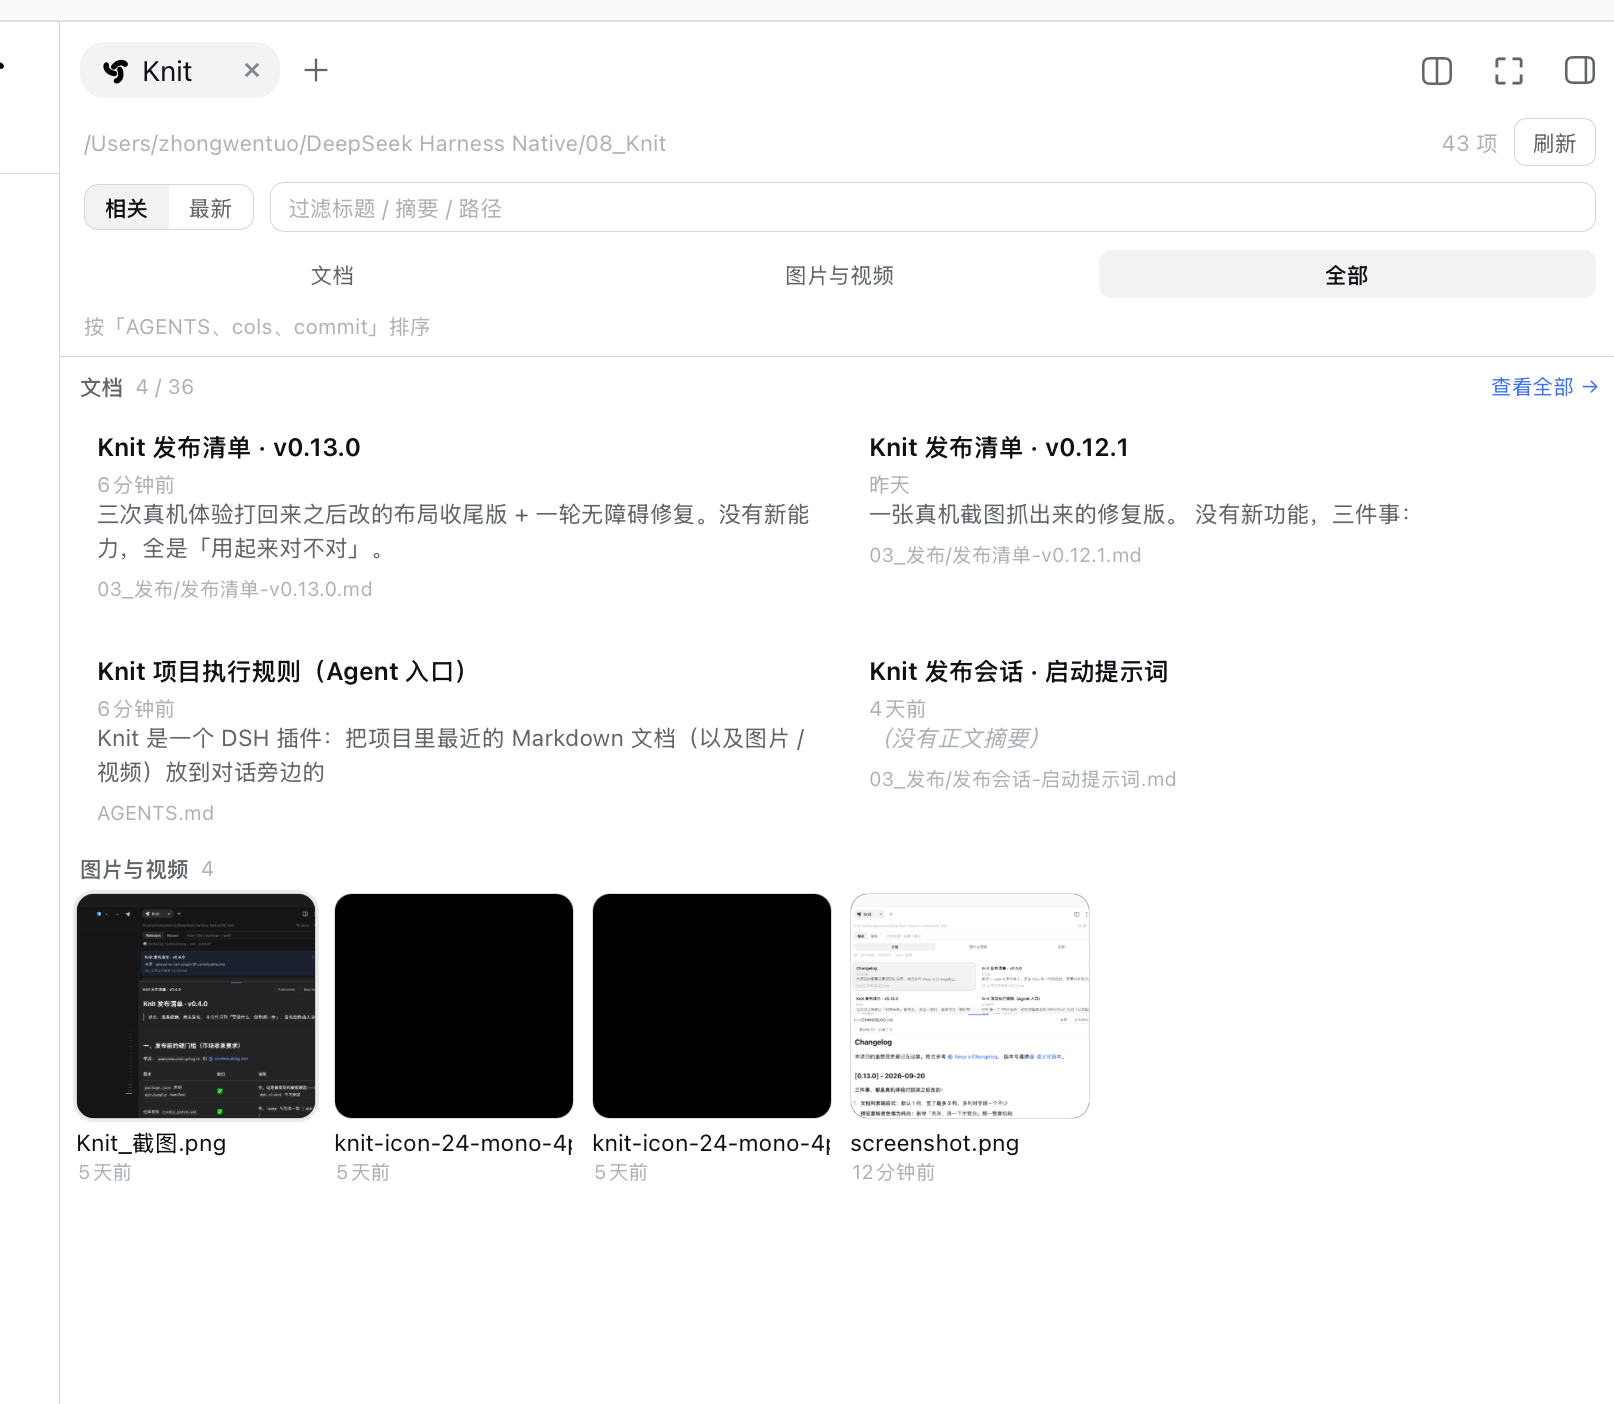
全部:上区文档最多 4 条,超出时右侧给「查看全部 →」(这一屏是「4 / 39」),下区是媒体网格。
⚠️ 上下两区共用宿主返回的同一个 40 条窗口:媒体如果按相关性排到第 40 名之外,
「全部」档就只剩窗口里那几个(这一屏只剩 1 个;「媒体」档不受影响,它单独取媒体)。
这是已知缺陷,复现与修法记在 docs/README.md。
当前任务上下文(v0.14)
排序解决的是「哪几篇跟这段对话最像」。但你要的往往是另一个问题的答案:
现在这个任务,项目里哪些东西最值得先看?
Context Pack 是对这个问题的回答,但它是数据层的结构(主要 / 辅助 / 相关三层 + 每条的确定性理由), 不是一张要单独显示的卡片。所以它直接落在文档列表里:相关模式下,文档档从一条平铺列表 变成三层分组,组名后面跟一句极短的说明。
┌─ 文档列表 ────────────────────────────┐
│ 主要上下文   先看                      │
│   01 ● 相关性排序算法      5分钟前     │
│      标题命中:排序                    │
│                                        │
│ 辅助上下文   辅助                      │
│   02  排序评测集           2小时前     │
│      正文命中:关键词计数              │
│                                        │
│ 相关上下文   背景                      │
│   03  CHANGELOG.md         12天前      │
│      正文命中:排序                    │
└────────────────────────────────────────┘
示意图省掉了每行的摘要。真实的行结构是:最左边独立一列=序号(与右边第一行垂直居中**), 右边堆叠=第一行「Primary 点 + 标题 + 相对时间(靠右)」→ 摘要(没有路径 —— 列表行里不显示它,路径在预览头上、目录收敛成
…/)。而且这个列表永远是单列(面板拖到多宽都一样)。 「其他相关文档」不在包里、不编号,那一列放一个中性的·占位 —— 但只在这一屏里有号时才放 (时间序 / 平铺列表整屏没号 ⇒ 一个标记都没有;混着才刺眼)。
分组之间不画横线:层级靠 16px 的空间、组名与字号建立,不靠分割线。 分组里没有分数、没有百分比、没有星级 —— 「为什么在这里」只写确定性的事实。
右侧那个「当前任务上下文」说明栏已经删掉了(2026-09-29)。它说的和左侧三个分组是同一件事 —— 当前任务就在列表上方那行弱化元信息里,「命中 N 篇」与头部总数重复,三条证据类型就是 三个组名;视觉价值有限,而且容易把 Knit 做成 AI Dashboard。随它一起删除的还有 「调宽 / 拖出浮动 / 右缘吸附」那一套(见
CHANGELOG.md)。
分层是确定性规则,不是 AI 判断
| 层 | 什么时候进 | 上限 |
|---|---|---|
| 主要上下文 | 命中,且有「落脚点」(话题词命中标题或摘要),且相关度不是背景噪音(≥ 最高分的 30%) | 1 |
| 辅助上下文 | 对某个「焦点词」有深入命中(该词不止一篇在讲,而且这一篇是把它讲得最多的那一篇);或与某个主要上下文有引用关系(「被引用」/「引用了」,两个方向分别标注) | 3 |
| 相关上下文 | 其余有命中的条目,以及零命中但有引用关系的邻居 | 5 |
上限是上限,不是配额:主要上下文允许为空(实测真实工作区上有相当比例的话题 确实没有一篇文档在正经讲它),相关上下文也允许为空。说不出的理由就不出场 —— 零命中又没有任何引用关系的文档不是「与当前任务有关」,放它进来只能配一句 「可能对你有帮助」,那是这一版明确不要的东西。
**「为什么在这里」**永远是一句可核验的事实:
| 理由 | 说的是什么 |
|---|---|
标题 / 摘要 / 正文命中当前话题:词 |
真的命中了,而且告诉你命中了哪个词 |
| 被主要上下文引用 | 主文档里那条路径指过来的 —— 读主文档时你下一步就会点它 |
| 引用了主要上下文 | 它里面提到了主文档 |
没有「AI 判断这篇重要」「可能对你有帮助」这类句子,也没有百分比、星级、置信度条 —— 理由要么是可核验的事实,要么干脆不写。
边界(说清楚,不夸大)
- 引用关系不等于「更相关」。 实测过:把引用图当排序信号补不上词面错配那个缺口。 所以引用关系只能把一篇文档放进辅助 / 相关层,永远不能把它抬进主要上下文。
- 排序引擎本身没变。 这一版加的是排序之上的一层投影 —— BM25 的打分、评测 (top-1 / MRR / 陷阱用例)一行没动。如果检索没把对的那篇找出来,分层也只能在 找到的那几篇里分 —— 它救不了召回。
- 不做任务理解。 Context Pack 里那个「当前任务」字段放的是最近一条用户消息的原文, 不是任何概括 —— Knit 不解一句话的意思,只是把它如实摆出来。真去概括需要模型,而 Knit 不调模型。
也给 agent 用:knit_docs 工具
同一份排序,除了给你看,也开了一个口子给模型。
装好之后,agent 的工具列表里会多一个 knit_docs:它可以问
「这个项目里跟当前话题最相关的文档是哪几篇」,拿回同一个 Context Pack ——
primary / supporting / related 三层,每项带路径 + 标题 + 摘要 +
结构化理由(direct / summaryMatch / bodyMatch / linkTarget / linkSource / related)
- 项目角色(
impl/test/config/design/doc)+ 命中的那一小段原文,再用它自己的read打开其中一篇。
为什么有用:agent 想引用项目里已有的文档时,只能靠猜路径、或者把 glob
出来的路径一个个 read 试过去。这份排序 Knit 每一轮已经算好了,这个工具只是把它交出去 ——
省掉的是**「先猜哪几篇相关」这一步判断**(实测:拿到包的 agent 不再需要 glob 去凑候选)。
只读,且不存储任何东西:它读的是项目里现成的文件,不是「记忆」。 和记忆类插件的区别是:它们起点是空的(agent 得先记过才有东西可召回), Knit 一装上就有整个项目的历史文档可用。
四个细节:
- 给的是任务上下文,不是一条平铺列表。面板与工具共用同一个 Context Model —— 没有两套排序逻辑,也没有两份规则。
- 不返回相关度分数。它是相对分数(永远有一篇 100%,每次刷新可能换人当), 给模型看会被当成绝对置信度去推理。顺序即相关度 —— 与面板同一条规矩。
- 不返回正文。agent 有自己的
read工具;Knit 负责发现,不负责搬运。 - 拿不到会话就报错,不兜底。HTTP 路由在会话查不到时会兜底到进程 cwd (兼容不带 sessionId 的老客户端),工具没有这个包袱 —— 兜底只会扫到一个不相干的项目并返回它的文档。宁可报错,也不返回错的东西。
⚠️ 代价要说清楚:工具描述会进每一次请求的系统提示词。